
チャットボットは、誰かの質問に答えています。回答が個人の立場に触れるのは、差別的な表現、性別や年齢に対する定型化された回答、根拠のない誹謗がそのまま利用者へ届くときです。被害は利用者と企業の信用の両方にのります。このガイドでは、人権リスクの3類型を整理し、設計で抑えるべき部分と運用で監視すべき部分を分けて実務手順で示します。
人権リスクは3つの類型で整理する
チャットボットの人権リスクは、どこで起きるかで分類すると対応が組み立てやすくなります。
| 類型 | 典型例 | 発生経路 | 主な対策 |
|---|---|---|---|
| 差別・偏見 | 性別や年齢を前提にした定型化された回答 | 学習データの偏り、指示文の欠落 | データ点検、指示文に公平性基準を明記 |
| 誹謗・名誉毀損 | 特定個人や組織への根拠のない言及 | ナレッジの誤り、無出典の生成 | 出典厳格モード、特定対象の断定答弁の禁止 |
| 二次的被害 | 攻撃的な会話が記録され、共有される | 感情の記録の可視性不足 | 感情分析、閲覧権限の限定、共有運用 |
この3類型は独立していません。誹謗を含む入力がFAQとして登録されれば、その回答が別の利用者に再配布されます。対策も入力・生成・流通の順に重ねます。チャットボットのセキュリティ完全ガイドで説明した4層構造と照らし合わせると、どこに手を入れるかが明確になります。

第1類型:差別と偏見を抑える ── データと指示の両面から
学習データに残る偏りを点検する
学習データやナレッジに偏りがあると、出力はその偏りを反映します。「看護師は女性」「若手はITを使わない」といった前提が文中に混ざっていないか、確認の頻度は四半期に一度程度で足ります。完璧に排除する必要はありませんが、根拠のない前提が断定として書かれている箇所は拾っておきます。
指示文に公平性の基準を書き込む
Botの指示文に「性別・年齢・国籍を前提とした断定をしない」「利用者が不利益を感じない表現を選ぶ」を明記します。指示文に書いてあれば、回答の生成側は自然にその方針に従います。あとから運用者が見返したときの確認基準にもなります。
第2類型:誹謗と名誉毀損を抑える ── 特定個人への断定答弁を避ける
出典厳格モードで、根拠のない生成を止める
知識検索型の質問では、検索結果で取得した証拠以外をAIの回答に使わない「出典厳格モード」をskill層で強制適用できます。検索結果が空や不十分な場合でも、モデル自身の常識や推測で穴埋めすることはありません。特定個人に関する質問で、検索結果に根拠がなければ「確認できる情報がありません」と返す形になります。
FAQには規程で確認できる事実だけを登録する
FAQには、料金、対応時間、手順、規約の条文のように第三者が確認できる事実のみを登録します。個人や企業への評価は、確認手段が限られるため原則として登録しません。登録の判断基準を「第三者が出典を確認できるか」と定めると、担当者が変わっても運用が安定します。
第3類型:利用者が二次的被害を受ける経路を塞ぐ
チャットボットは、攻撃的な言葉を投げた側ではなく、応答を受け取った側にも被害をもたらし得ます。記録が残り、共有され、引用される経路を塞ぐ必要があります。
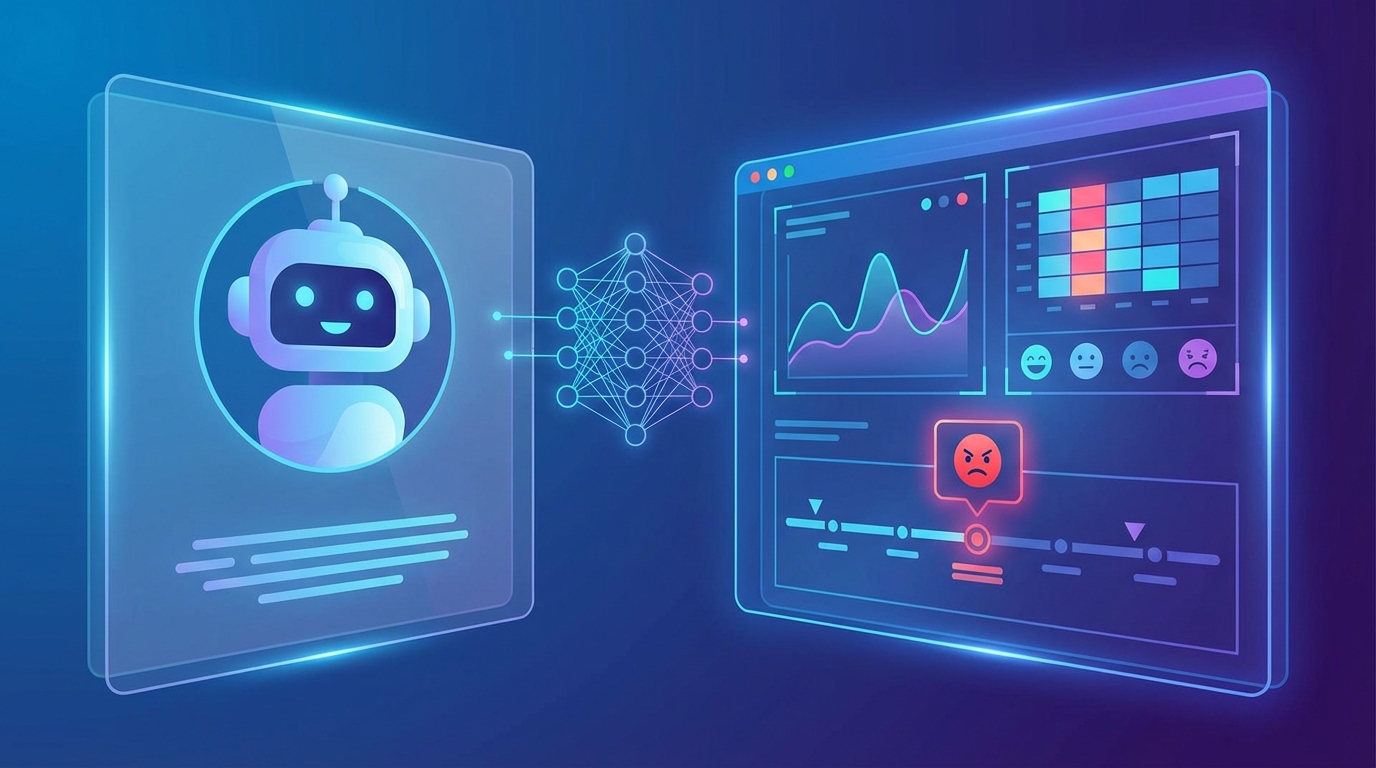
感情分析で攻撃の兆候を検知する
GBase Supportの分析機能には、感情分析によるカスハラの早期検知と自動エスカレーションの仕組みが備わっています。会話に攻撃的な要素が含まれたら、その場で有人対応へ引き継ぎます。カスハラ対応完全ガイドが示す初動手順と組み合わせると、被害の拡大を止められます。社内の対応規程を定める際はカスハラ対応の規定と社内対応も参照してください。
会話の共有経路を限定する
会話のスクリーンショットは、共有が容易であるぶん管理も必要です。共有先を社内の対応者グループに限定し、外部のSNSなどへの投稿は就業規程で禁じる運用にします。分析画面の閲覧範囲は所属者に絞り、共有用の書き出しは別承認にする運用にします。
運用設計 ── 監視・レビュー・エスカレーションの基準
週次で見る4つの指標
GBase Supportの分析画面では、会話数・解決率・満足度・FAQ使用率を確認できます。人権リスクとの関連は、次のように指標から推測します。
| 指標 | 監視の観点 | 放置した場合の兆候 |
|---|---|---|
| 会話数 | 特定Botや時間帯への集中 | 攻撃的な入力の集積 |
| 解決率 | 急低下 | 偏った回答が繰り返し出ている |
| 満足度 | 低評価の偏り | 同内容の被害が複数件起きている |
| FAQ使用率 | 特定FAQへの偏り | 誤ったFAQが広く配布されている |
低評価は「不快」と「不当」を分けて読む
低評価が1件だけなら偶然の要素が大きいですが、同じ話題が複数件にまたがれば、回答側の問題として扱う必要があります。回答の傾向は分析画面で可視化し、担当部門と共有します。件数が減っていても内容が悪い回答は減らないため、指標は週次、内容は月次で確認するのが現実的です。
エスカレーション基準を数字で書く
「重い案件は上へ報告する」という書き方では、誰も判断できません。攻撃的な要素を含む会話が1件、同一利用者からの高頻度入力が1日10件、確認済みの誤りが回答に混ざっていたのが1件、というように閾値を数字で書いておきます。
人権リスクアセスメントの5ステップ
| # | ステップ | 実施内容 | 成果物 |
|---|---|---|---|
| 1 | 資産の棚卸し | 公開中のBot、FAQ、外部連携先の一覧化 | 一覧表 |
| 2 | 回答の点検 | 高リスクな質問を想定して回答を確認 | 点検記録 |
| 3 | 指示文の見直し | 公平性・出典・断定禁止の明記 | 改訂した指示文 |
| 4 | 監視の設定 | 指標と閾値を登録 | 監視項目表 |
| 5 | 定期の見直し | 四半期ごとの再点検 | 点検報告書 |

GBase Supportなら、人権リスクを抑える設計と監視を標準装備で実現できます
よくある質問
Q1: チャットボットの回答が人権侵害にあたる場合、責任は誰にありますか?
回答の内容と、それを配信した経路の両方で判断されます。学習データや指示文の設計、内部のレビュー運用までを合わせて確認されます。外部に公開したチャットボットの回答についての説明責任は事業者側にあります。設計記録と監視記録を残しておくと、説明の根拠になります。
Q2: 差別的な表現は自動で検出できますか?
自動判定には誤判定が伴うため、自動判定を「問題の修正」ではなく「確認のきっかけ」として使うのが現実的です。感情分析は攻撃的な会話の検知に役立つ一方、判定は人の確認を挟んでから反映します。NPSアンケートとはで説明する満足度と組み合わせると、件数と質の両方を捉えられます。
Q3: 誹謗を防ぐため、FAQの登録基準をどう決めればよいですか?
登録基準の軸は「第三者が出典を確認できるか」です。料金、対応時間、手順、規約の条文は確認できるため登録してよい一方、個人や企業への評価は確認手段が限られるため、原則として登録しません。判断に迷うものは削除ではなく保留にし、四半期ごとの見直しで判断します。
Q4: 多言語で運用する場合も基準は同じですか?
同じです。ただし、翻訳のずれによって「原文では断定していないはずの表現が他言語では断定的になる」ケースがあります。多言語で運用している場合は、各言語の回答を最低1件ずつ点検し、表現の強弱が言語間で揃っているかを確認します。
Q5: 運用担当者が不在の日はどう扱いますか?
監視項目は自動計測されるもの、会話数・解決率・満足度・FAQ使用率と、ツール呼び出しの成功率および所要時間だけにします。人手が必要な確認は「週1回・担当者に連絡が回る運用」とし、攻撃的な会話の検知は自動エスカレーションで有人へ引き継ぎます。チャットボットの課題と対策も参照し、運用の抜けを塞いでください。
まとめ
AIチャットボットの人権リスクは、モデルの性質ではなく、設計と運用の置き場所で決まります。差別と偏見はデータと指示で、誹謗と名誉毀損は出典制御と登録基準で、二次的被害は感情分析と共有範囲の限定でしか防げません。3本立てで設計し、四半期ごとのアセスメントで点検を続ける運用が基本線です。
GBase Supportは、出典厳格モード、感情分析によるカスハラ早期検知と自動エスカレーション、分析画面の4指標、Botごとの指示文編集を備えています。設計と点検の前提が最初から揃っているため、運用規約の記述もそのまま書けます。